- SWE-Bench Verified 80.2
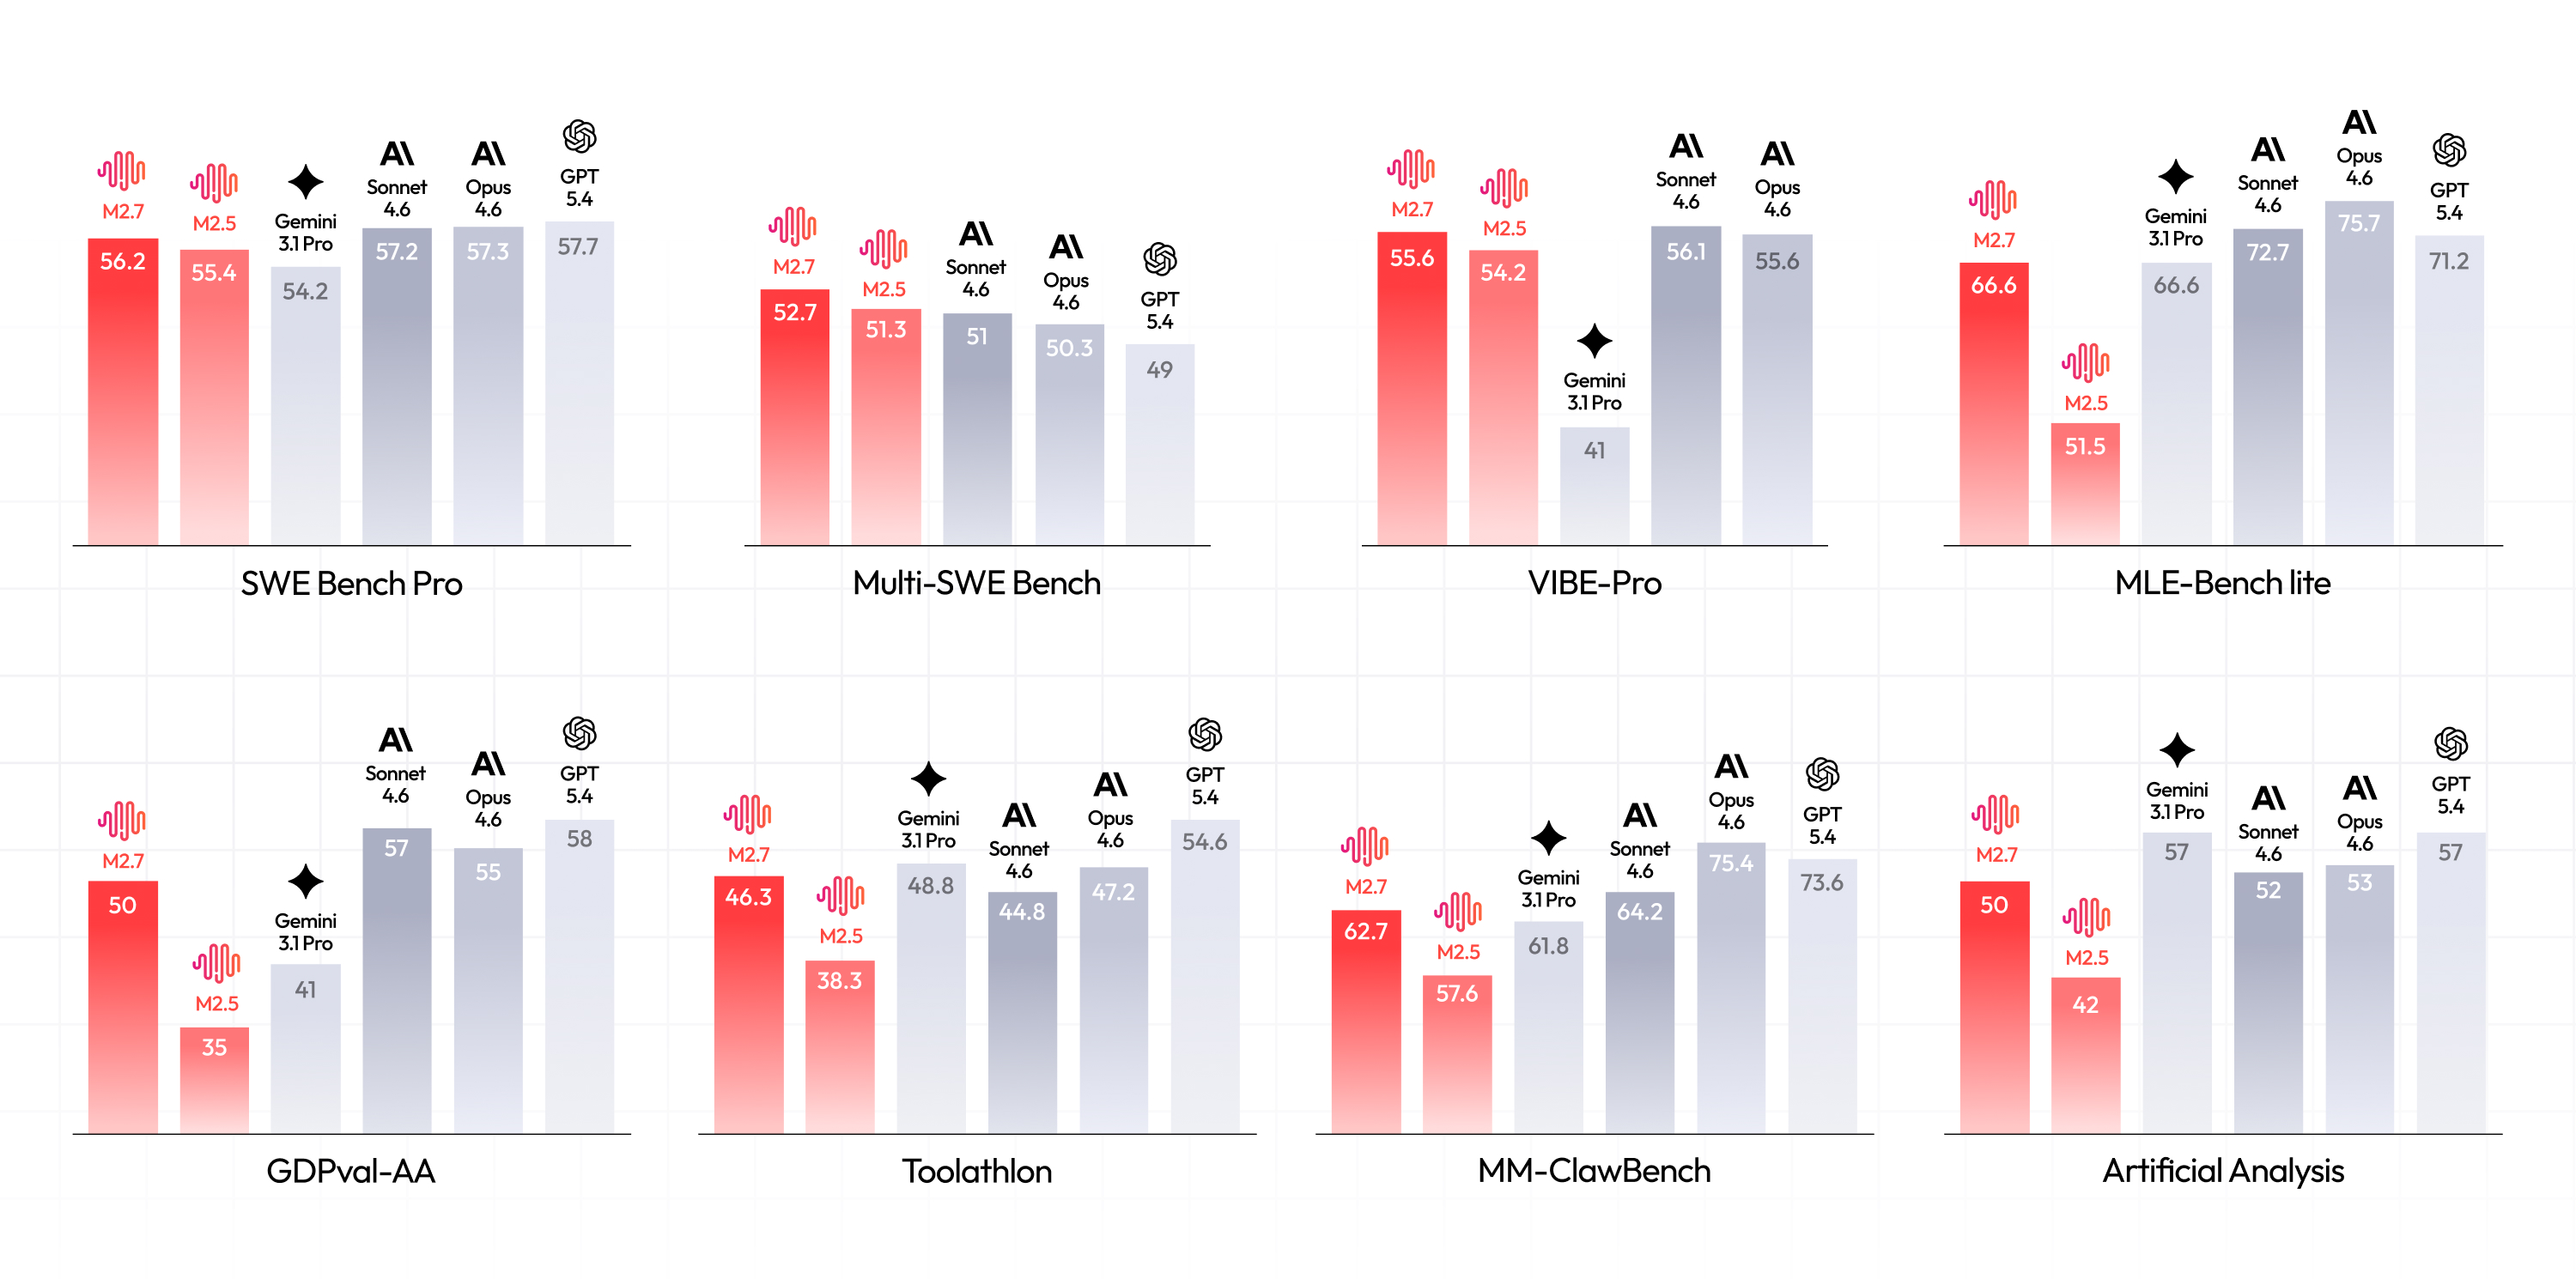
- SWE-Bench Pro 55.4
- Terminal Bench 2 51.7
- Multi-SWE-Bench 51.3
- SWE-Bench Multilingual 74.1
- VIBE-Pro (AVG) 54.2
- BrowseComp (w/ctx) 76.3
- Wide Search 70.3
- RISE 50.2
- BFCL multi-turn
- τ² Telecom 97.8
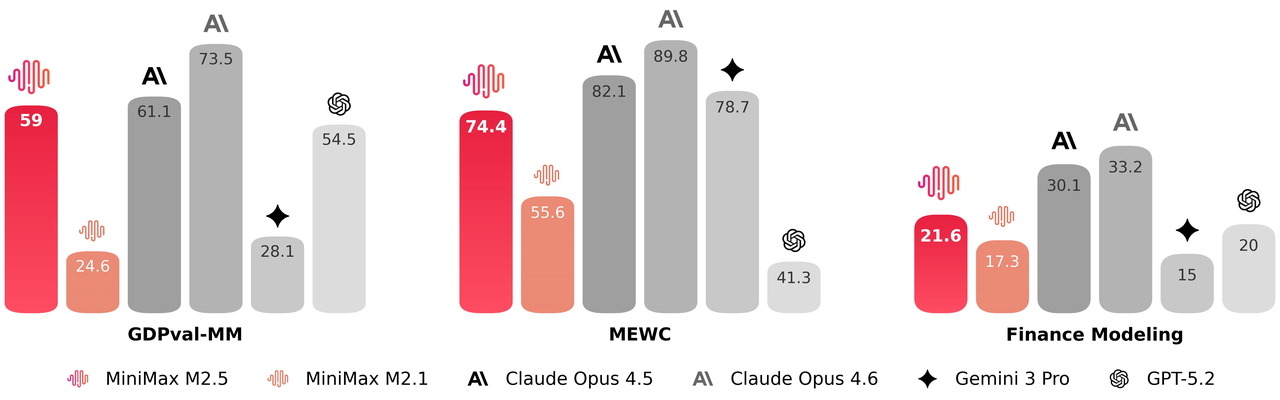
- GDPval-MM 59
- MEWC 74.4
- Finance Modeling 21.6
- AIME25 86.3
- GPQA-D 85.2
- HLE w/o tools 19.4
- SciCode 44.4
- IFBench 70
- AA-LCR 69.5
MiniMax-M2.5
MiniMax-M2.5 places in the top three on 3 benchmarks.
94
Benchmarks with a score
0
Ranked first, out of five or more models
3
In the top three
 MiniMax Feb 2026
MiniMax-M2.5
Open weights Flagship
147.8
#110 of 404
Self-Reported Index, from the lab's own numbers. No Epoch Capabilities Index score yet.
- IFBench 72% #35 /80
- Terminal-Bench 2.0 42.7% #23 /43
- SciCode 44.4% #21 /49
Where it ranks
Its best score on each benchmark, and where that ranks among every model with a score there. We rank each model once, at its best setting.
Knowledge and language
| Benchmark | Score | Rank | Source | |
|---|---|---|---|---|
| MMLU-Pro | 85.2% | #26 of 167 | Lab model card | |
| AA-LCR (Artificial Analysis Long Context Reasoning) | 69.5% | #9 of 38 | Lab model card | |
| LMArena (Elo) | 1,391 | #142 of 335 | Official leaderboard | |
| IFBench | 72% | #35 of 80 | Lab model card | |
| Vectara Hallucination Leaderboard (2025 dataset) | 9.10% | #46 of 104 | Official leaderboard | |
| Longform Creative Writing (EQ-Bench) | 65.3 | #54 of 119 | Official leaderboard | |
| KINA | 30.3% | #18 of 37 | Official leaderboard | |
| LOCA-Bench | 6.70% | #5 of 9 | Official leaderboard | |
| WideSearch | 70.3% | #11 of 19 | Lab model card | |
| Judgemark v2.1 | 64.5 | #28 of 42 | Official leaderboard | |
| Creative Writing v3 | 60.2 | #82 of 120 | Official leaderboard | |
| Humanity's Last Exam | 19.4% | #106 of 154 | Lab model card | |
| BullshitBench | 16.4% | #78 of 107 | Official leaderboard | |
| StudyArena Text | 1,189 | #69 of 85 | Official leaderboard | |
| Extended NYT Connections | 16.8% | #90 of 103 | Official leaderboard | |
| BullshitBench V2 | 9.00% | #116 of 129 | Official leaderboard | |
| STALE | 5.50% | #9 of 10 | Official leaderboard | |
| CL-bench | 11.4% | #24 of 24 | Official leaderboard | |
| SkateBench v2 | 13.8% | #21 of 21 | Official leaderboard | |
| CL-bench Life | 6.30% | #16 of 16 | Official leaderboard |
Math and science
| Benchmark | Score | Rank | Source | |
|---|---|---|---|---|
| GPQA Diamond | 85.2% | #77 of 302 | Lab model card | |
| AIME 2025 | 86.3% | #67 of 143 | Lab model card | |
| ARC-AGI | 63.7% | #59 of 95 | Official leaderboard | |
| ARC-AGI-2 | 4.86% | #71 of 98 | Official leaderboard | |
| AIME 2026 | 87.2% | #31 of 38 | Lab model card | |
| Echo General AI Prediction Leaderboard | 979 | #14 of 17 | Official leaderboard | |
| ProofBench | 4.00% | #54 of 59 | Official leaderboard | |
| ChemBench | 43.5% | #23 of 24 | Official leaderboard |
Coding
| Benchmark | Score | Rank | Source | |
|---|---|---|---|---|
| SWE-bench Verified | 75.8% | #5 of 60 | Official leaderboard | |
| Multi-SWE-bench | 51.3% | #2 of 10 | Lab model card | |
| MLE-bench | 51.5% | #4 of 10 | Lab model card | |
| SciCode | 44.4% | #21 of 49 | Lab model card | |
| SWE-bench Multilingual | 74.1% | #32 of 73 | Lab model card | |
| DesignArena Website | 1,215 | #74 of 151 | Official leaderboard | |
| DesignArena Code | 1,197 | #74 of 143 | Official leaderboard | |
| DesignArena 3D Design | 1,153 | #74 of 136 | Official leaderboard | |
| DesignArena Game Dev | 1,166 | #79 of 143 | Official leaderboard | |
| ContextBench | 23.6% | #5 of 9 | Official leaderboard | |
| DesignArena UI Component | 1,164 | #82 of 139 | Official leaderboard | |
| SWE-Bench Pro | 55.4% | #49 of 81 | Lab model card | |
| DesignArena SVG | 1,139 | #63 of 103 | Official leaderboard | |
| OpenHands Index | 45.2% | #22 of 33 | Official leaderboard | |
| VIBE-Pro (MiniMax) | 54.2% | #2 of 3 | Lab model card | |
| DesignArena Data Visualization | 1,169 | #79 of 118 | Official leaderboard | |
| IOI (Vals) | 6.67% | #37 of 55 | Official leaderboard | |
| WebDev Arena | 1,384 | #73 of 105 | arena.ai, via Epoch AI | |
| Code Arena | 1,386 | #92 of 128 | Official leaderboard | |
| Vibe Code Bench | 14.8% | #95 of 120 | Official leaderboard | |
| ALE-Bench | 1,033 | #101 of 126 | Official leaderboard | |
| PostTrainBench | 9.50% | #19 of 23 | Official leaderboard | |
| FrontierCode | 5.34% | #11 of 12 | Official leaderboard | |
| SWE Atlas Refactoring | 19.5% | #16 of 17 | Official leaderboard | |
| SWE Atlas | 10.3% | #21 of 22 | Official leaderboard | |
| NL2Repo-Bench | 26.6% | #30 of 30 | Lab model card | |
| SWE Atlas Test Writing | 18.6% | #22 of 22 | Official leaderboard | |
| OJBench | 41.4% | #8 of 8 | Official leaderboard | |
| HyperTask | 59.4% | #2 of 2 | Lab model card |
Agents and tools
| Benchmark | Score | Rank | Source | |
|---|---|---|---|---|
| tau2-bench | 97.8% | #3 of 79 | Lab model card | |
| SnakeBench | 27 | #59 of 188 | Official leaderboard | |
| LisanBench | 852.5 | #58 of 133 | Official leaderboard | |
| Toolathlon | 38.3% | #22 of 50 | Official leaderboard | |
| BrowseComp | 76.3% | #39 of 81 | Lab model card | |
| Pencil Puzzle Bench | 3.30% | #28 of 53 | Official leaderboard | |
| Terminal-Bench 2.0 | 42.7% | #23 of 43 | Official leaderboard | |
| PinchBench | 67.2% | #26 of 48 | Official leaderboard | |
| MM-BrowseComp | 4.25% | #7 of 11 | Official leaderboard | |
| ClawProBench | 51.8% | #40 of 49 | Official leaderboard | |
| Claw-Eval-Live | 50.5% | #10 of 12 | Official leaderboard | |
| AutoResearchBench | 2.91% | #11 of 13 | Official leaderboard | |
| WildClawBench | 27.1% | #30 of 31 | Official leaderboard | |
| ClawBench V2 | 1.50% | #7 of 7 | Official leaderboard | |
| MM-ClawBench | 57.6% | #6 of 6 | Official leaderboard | |
| RISE | 50.2% | #2 of 2 | Lab model card |
Professional work
| Benchmark | Score | Rank | Source | |
|---|---|---|---|---|
| GDPval-MM | 59% | #3 of 6 | Official leaderboard | |
| CorpFin v2 | 59.6% | #74 of 119 | Official leaderboard | |
| LegalBench | 80% | #87 of 138 | Official leaderboard | |
| TaxEval v2 | 68.2% | #94 of 129 | Official leaderboard | |
| CaseLaw v2 | 53.5% | #40 of 53 | Official leaderboard | |
| ProfBench | 42.2% | #57 of 72 | Official leaderboard | |
| Vals Finance Agent | 38.6% | #40 of 49 | Official leaderboard | |
| FoodTruck Bench | $-317 | #58 of 59 | Official leaderboard | |
| Vending-Bench 2 | $-23 | #66 of 67 | Official leaderboard | |
| SpreadsheetBench 2 | 7.17% | #8 of 8 | Official leaderboard | |
| AlphaEval | 40.9% | #5 of 5 | Official leaderboard | |
| Finance Modeling Pro | 33.8% | #2 of 2 | Lab model card | |
| MEWC v2 | 49.8% | #2 of 2 | Lab model card | |
| Finance Modeling | 21.6% | #1 of 1 | Lab model card | |
| MEWC | 74.4% | #1 of 1 | Lab model card |
Vision, audio and robotics
| Benchmark | Score | Rank | Source | |
|---|---|---|---|---|
| MineBench | 1,068 | #64 of 75 | Official leaderboard |
Safety and security
| Benchmark | Score | Rank | Source | |
|---|---|---|---|---|
| LiveSecBench | 61.6 | #12 of 34 | Official leaderboard | |
| nocot-bench (NCRI) | 65.0 | #122 of 185 | Official leaderboard | |
| SEC-bench Pro | 0% | #6 of 6 | Official leaderboard | |
| SEC-bench Pro 260617 | 0.60% | #6 of 6 | Official leaderboard |
Other
| Benchmark | Score | Rank | Source | |
|---|---|---|---|---|
| Artificial Analysis Intelligence Index v4.0 | 42.0 | #4 of 5 | Lab model card |
Its lab's numbers put it at 147.8, number 110 of 404
The Self-Reported Index fits one score to the 18 capability results MiniMax reported for this model, on the scale of the Epoch Capabilities Index. Labs choose which benchmarks to show and how to run them, so read it as the lab's claim, not an independent measurement. The 90% interval runs from 145.6 to 150.0. How we compute it.
- tau2-bench 97.8
- AIME 2026 87.2
- AIME 2025 86.3
- GPQA Diamond 85.2
- MMLU-Pro 85.2
- SWE-bench Verified 80.2
- BrowseComp 76.3
- SWE-bench Multilingual 74.1
- IFBench 72
- WideSearch 70.3
- AA-LCR (Artificial Analysis Long Context Reasoning) 69.5
- SWE-Bench Pro 55.4
- Terminal-Bench 2.0 51.7
- Multi-SWE-bench 51.3
- SciCode 44.4
- Toolathlon 38.3
- NL2Repo-Bench 26.6
- Humanity's Last Exam 19.4
Its lab's numbers next to 7 leaderboards
Where the benchmark's own leaderboard, or Epoch AI's run, also has this model. Gaps mostly come from different harnesses, effort levels and task subsets. Every pair.
| Benchmark | Lab says | Board says | Gap |
|---|---|---|---|
| Terminal-Bench 2.0 | 51.7% Terminal Bench 2 | 42.7% Leaderboard, cchuter | +9.0 pts |
| SWE-bench Multilingual | 74.1% SWE-Bench Multilingual | 68.3% Leaderboard, mini-SWE-agent | +5.8 pts |
| MMLU-Pro | 85.2% MMLU-Pro, AA Index v4.0 protocol (Table 4) | 80.1% Leaderboard | +5.1 pts |
| SWE-bench Verified | 80.2% SWE-Bench Verified | 75.8% Leaderboard, high, mini-SWE-agent | +4.4 pts |
| GDPval-MM | 59% GDPval-MM | 59% Leaderboard | Same |
| MM-ClawBench | 57.6% MM Claw (Table 4) | 57.6% Leaderboard | Same |
| Toolathlon | 38.3% Toolathlon (Table 4) | 38.3% Leaderboard | Same |
Its launch post
The benchmarks the lab chose to headline, with the scores it gave.
Its system card
Every result in the longer documents the lab published with it. 11 of them aren't in the launch post.
Capabilities
- SWE-Bench Pro 55.4
- SWE-bench Multilingual 74.1
- Multi-SWE-bench 51.3
- NL2Repo-Bench 26.6
- Terminal-Bench 2.0 51.7
- VIBE-Pro (MiniMax) 54.2
- HyperTask 59.4
- BrowseComp 76.3
- WideSearch 70.3
- RISE 50.2
- GDPval-AA 35
- Toolathlon 38.3
- MM-ClawBench 57.6
- MEWC v2 49.8
- Finance Modeling Pro 33.8
- AIME 2026 87.2
- GPQA Diamond 85.2
- SciCode 43
- IFBench 72
- AA-LCR (Artificial Analysis Long Context Reasoning) 65
- Humanity's Last Exam 19
- MMLU-Pro 85.2
- AIME 2025 86.3
- Artificial Analysis Intelligence Index v4.0 42
AI R&D risk
- MLE-bench 51.5