Benchmark Almanac

MiniMax-M2.7

MiniMax-M2.7 ranks first on Multi-SWE-bench.

MiniMax Released March 18th, 2026 Family MiniMax-M2 The lab's model card Compare with others
119
Benchmarks with a score
1
Ranked first, out of five or more models
5
In the top three
MiniMax Mar 2026

MiniMax-M2.7

Open weights Flagship

150.3 #89 of 404
Self-Reported Index, from the lab's own numbers. No Epoch Capabilities Index score yet.
  • IFBench 76% #21 /80
  • Terminal-Bench 2.0 45.1% #20 /43
  • AutomationBench 0.46% #41 /42

Where it ranks

Its best score on each benchmark, and where that ranks among every model with a score there. We rank each model once, at its best setting.

Knowledge and language

BenchmarkScoreRankSource
AA-LCR (Artificial Analysis Long Context Reasoning) 72% #5 of 38 Lab model card
EvoArena SWE-Chain-Evo 42.3% #2 of 8 Official leaderboard
IFBench 76% #21 of 80 Lab model card
WideSearch 75.2% #6 of 19 Lab model card
LMArena (Elo) 1,415 #112 of 335 Official leaderboard
Wer wird Millionär? LLM Benchmark 27022.0 #27 of 77 Official leaderboard
MMLU-Pro 81.8% #63 of 167 Lab model card
AgentIF (2026-10 setting) 61.9% #13 of 24 Official leaderboard
Humanity's Last Exam 28% #85 of 154 Lab model card
EvoArena Terminal-Bench-Evo 42.4% #5 of 8 Official leaderboard
EvoArena PersonaMem-Evo 47.9% #6 of 8 Official leaderboard
DesignArena ASCII Art 1,129 #58 of 77 Official leaderboard
Extended NYT Connections 24.7% #86 of 103 Official leaderboard
Vectara Hallucination Leaderboard (2025 dataset) 12.9% #87 of 104 Official leaderboard
HLE Extended 6.60% #28 of 31 Official leaderboard
BullshitBench V2 8.00% #120 of 129 Official leaderboard
AA-LCR Extended 28.4% #46 of 49 Official leaderboard
Lech Mazur Creative Writing -3.81 #48 of 50 Official leaderboard

Math and science

BenchmarkScoreRankSource
GPQA Diamond 89.8% #36 of 302 Lab model card
AIME 2025 94% #28 of 143 Lab model card
Echo General AI Prediction Leaderboard 1,001 #7 of 17 Official leaderboard
AIME 2026 94.2% #17 of 38 Lab model card
ProofBench 3.00% #55 of 59 Official leaderboard
NatureBench 1.11% #18 of 18 Official leaderboard

Coding

BenchmarkScoreRankSource
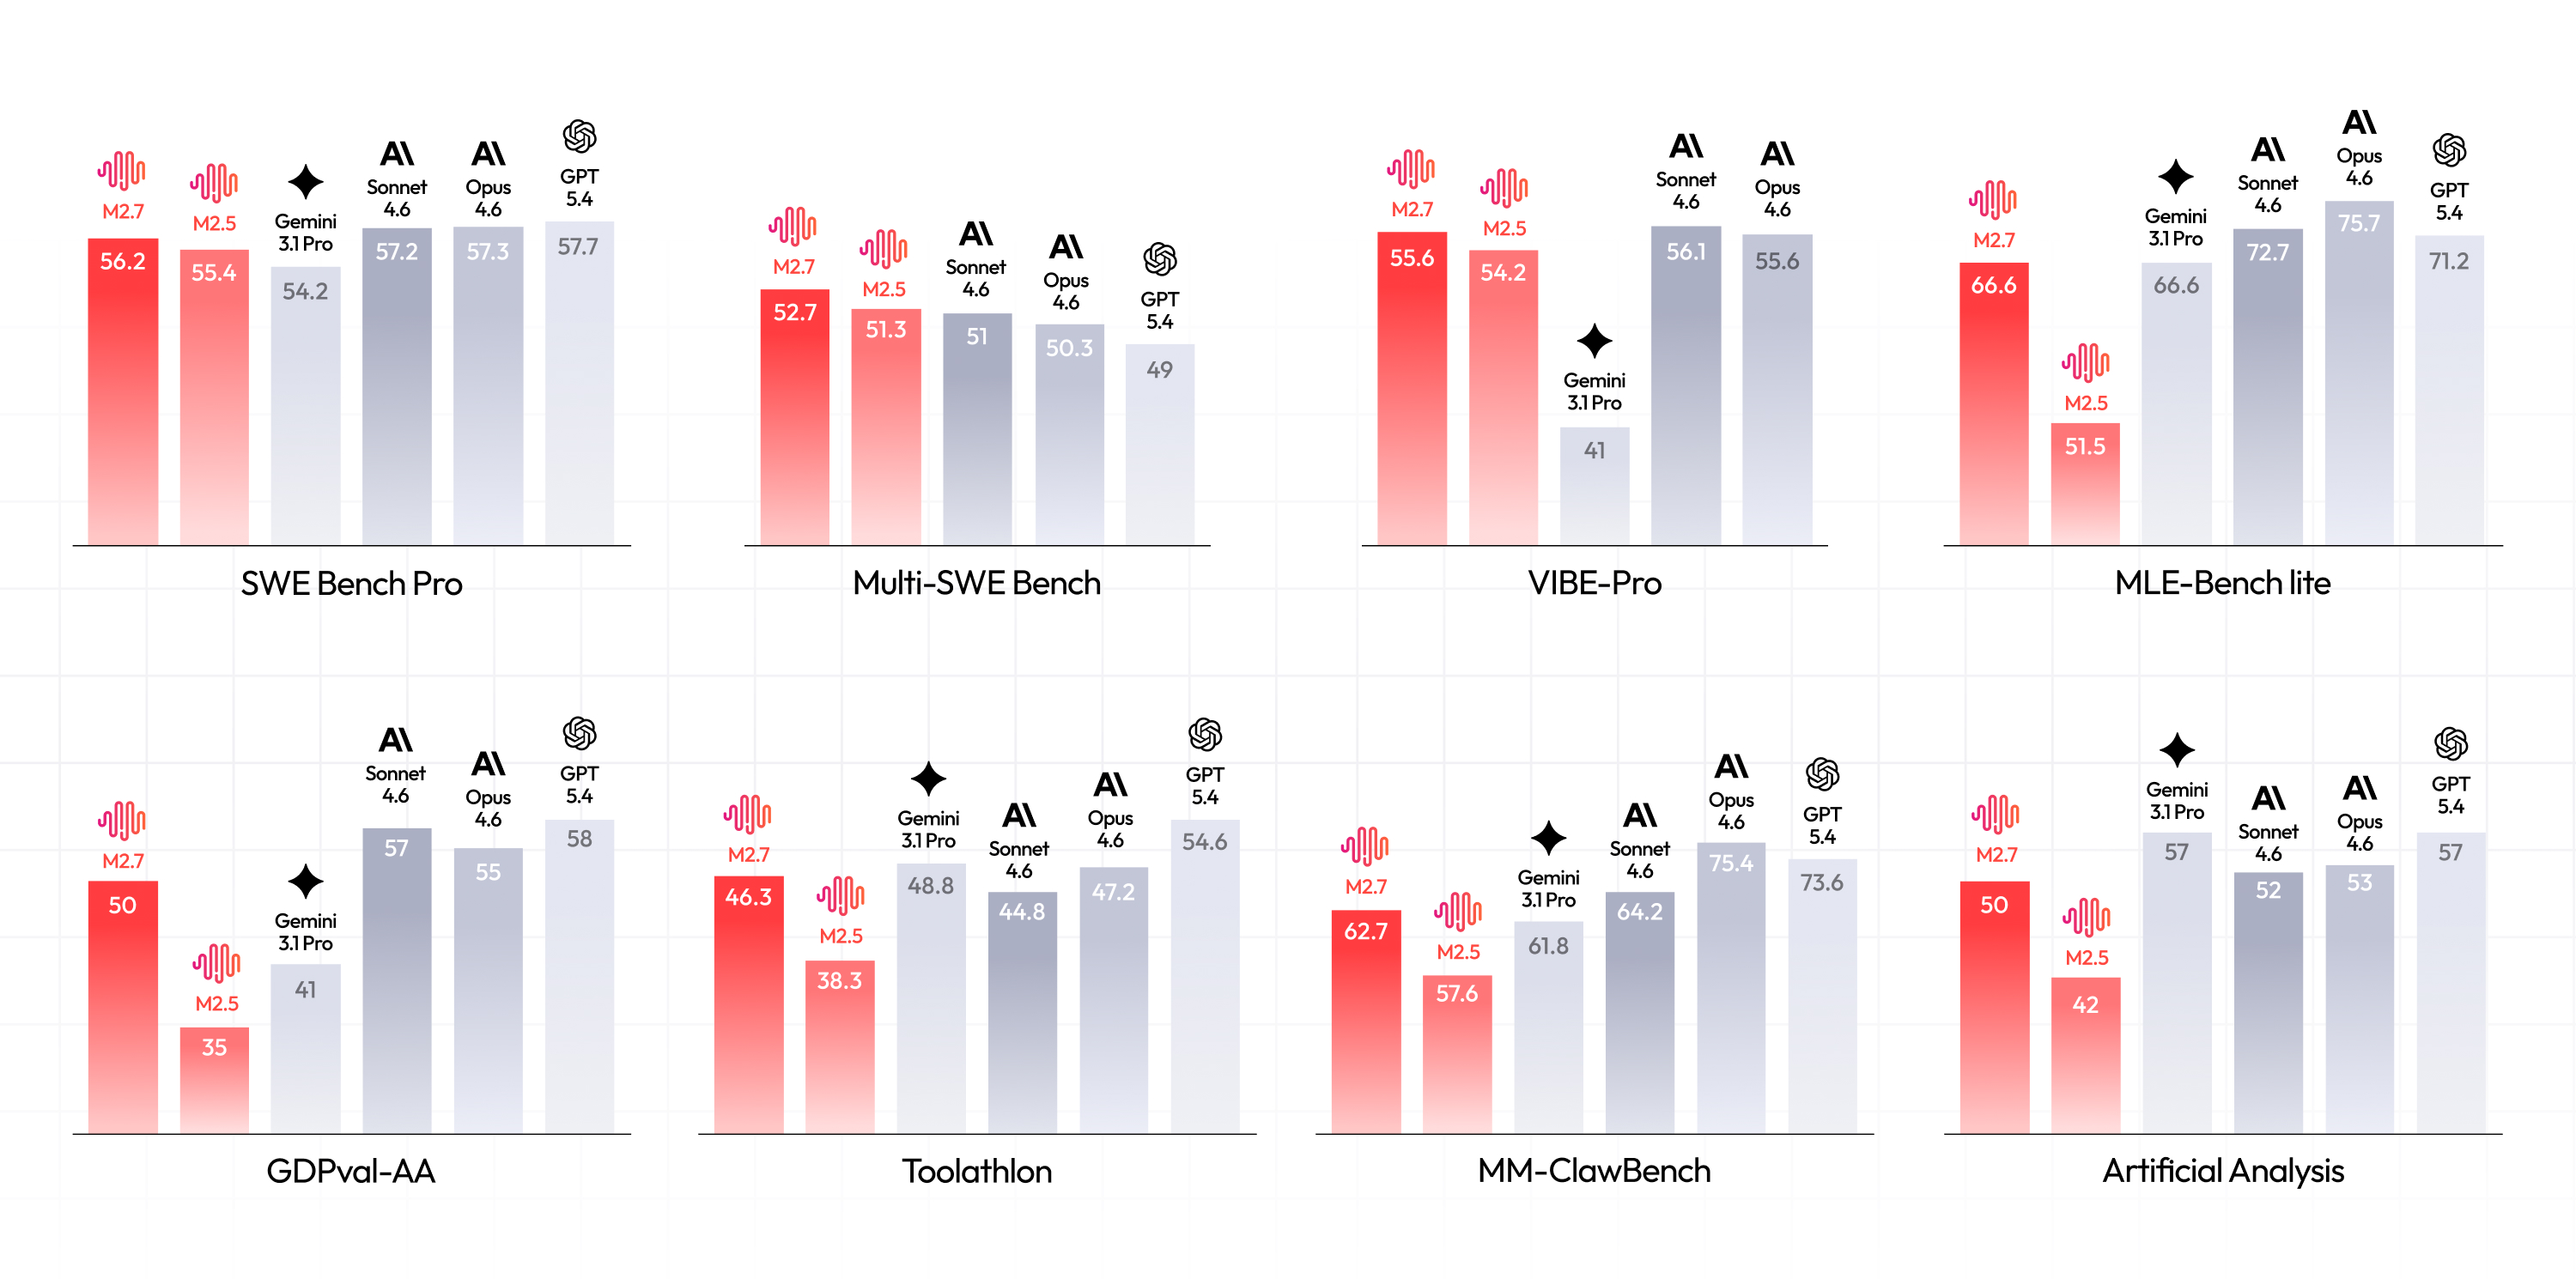
Multi-SWE-bench 52.7% #1 of 10 Lab model card
LiveSQLBench 33.2% #6 of 36 Official leaderboard
MLE-bench 66.6% #2 of 10 Lab model card
VIBE-Pro (MiniMax) 55.6% #1 of 3 Lab model card
SWE-bench Multilingual 76.5% #26 of 73 Lab model card
SciCode 47% #18 of 49 Lab model card
DesignArena Website 1,235 #64 of 151 Official leaderboard
DesignArena Data Visualization 1,230 #51 of 118 Official leaderboard
DesignArena Game Dev 1,199 #65 of 143 Official leaderboard
DesignArena Code 1,224 #66 of 143 Official leaderboard
DesignArena 3D Design 1,178 #67 of 136 Official leaderboard
HyperTask 67.6% #1 of 2 Lab model card
DesignArena UI Component 1,203 #70 of 139 Official leaderboard
SWE-Bench Pro 56.2% #45 of 81 Lab model card
WebDev Arena 1,398 #67 of 105 arena.ai, via Epoch AI
DesignArena SVG 1,124 #68 of 103 Official leaderboard
Code Arena 1,398 #87 of 128 Official leaderboard
IOI (Vals) 4.92% #41 of 55 Official leaderboard
FrontierCode 5.98% #9 of 12 Official leaderboard
OpenHands Index 43.4% #25 of 33 Official leaderboard
NL2Repo-Bench 39.8% #24 of 30 Lab model card
WeirdML 37% #90 of 112 Official leaderboard
ALE-Bench 1,021 #102 of 126 Official leaderboard
Code Migration 8.69% #65 of 78 Official leaderboard
Vibe Code Bench 11.9% #101 of 120 Official leaderboard
SWE Atlas Codebase QnA Extended 0.70% #33 of 38 Official leaderboard
AutoLab 0.27 #9 of 10 Official leaderboard
SWE-Marathon 0% #11 of 12 Official leaderboard
EvoCode-Bench 3.70% #12 of 13 Official leaderboard
GameCraft-Bench 10.9% #14 of 15 Official leaderboard
AndroidBench 41.6% #30 of 32 Official leaderboard
Claw-SWE-Bench 61.4% #15 of 16 Official leaderboard
APEX-SWE 21.5% #61 of 65 Official leaderboard
SWE-bench Verified Extended 6.70% #44 of 44 Official leaderboard
SlopCodeBench 4.08% #22 of 22 Official leaderboard
EvoCode-Bench v2 5.10% #13 of 13 Official leaderboard
RoadmapBench 10.4% #11 of 11 Official leaderboard

Agents and tools

BenchmarkScoreRankSource
PinchBench 80.6% #4 of 48 Official leaderboard
Toolathlon 46.3% #12 of 50 Official leaderboard
Claw-Eval-Live 54.3% #5 of 12 Official leaderboard
BrowseComp 77.8% #34 of 81 Lab model card
Terminal-Bench 2.0 45.1% #20 of 43 Official leaderboard
RISE 64.3% #1 of 2 Lab model card
EnvSimBench 41.8% #4 of 7 Official leaderboard
SnakeBench 22 #111 of 188 Official leaderboard
LiveClawBench 68.4% #11 of 17 Official leaderboard
PinchBench 2.0 66.8% #37 of 57 Official leaderboard
MM-ClawBench 62.7% #4 of 6 Official leaderboard
CivBench 1,470 #14 of 19 Official leaderboard
Clocktower Radio 1,415 #17 of 23 Official leaderboard
VitaBench 2.0 35.1% #13 of 17 Official leaderboard
WildClawBench 37.1% #25 of 31 Official leaderboard
Claw-Eval 72.6% #20 of 24 Official leaderboard
Toolathlon-Verified 47.5% #21 of 25 Official leaderboard
ClawProBench 49.5% #42 of 49 Official leaderboard
Claw-Eval Pass^3 48.7% #21 of 24 Official leaderboard
SkillsBench 34.9% #20 of 22 Official leaderboard
Pencil Puzzle Bench 0% #50 of 53 Official leaderboard
AutomationBench 0.46% #41 of 42 Official leaderboard
Terminal-Bench 2.1 Extended 10.1% #44 of 44 Official leaderboard
BrowseComp Extended 0.50% #42 of 42 Official leaderboard
QwenClawBench 50.5% #12 of 12 Official leaderboard
DeepTerminalBench 10% #9 of 9 Official leaderboard

Professional work

BenchmarkScoreRankSource
LegalBench 84% #44 of 138 Official leaderboard
CaseLaw v2 60.9% #23 of 53 Official leaderboard
Workspace-Bench-Lite 54.6% #4 of 9 Official leaderboard
CorpFin v2 61.2% #58 of 119 Official leaderboard
Finance Modeling Pro 57% #1 of 2 Lab model card
MEWC v2 63.3% #1 of 2 Lab model card
GDPval-AA 1,495 #9 of 16 Lab model card
MedScribe 79.9% #56 of 97 Official leaderboard
ProfBench 45.2% #42 of 72 Official leaderboard
Vals Finance Agent 48.4% #29 of 49 Official leaderboard
Vals Index v1 49.9% #24 of 34 Official leaderboard
MedCode 34.4% #74 of 96 Official leaderboard
TaxEval v2 66.6% #102 of 129 Official leaderboard
GDPval Extended 0.20% #35 of 43 Official leaderboard
PhysicianBench 8.70% #11 of 13 Official leaderboard
Vals Index v2 24.6% #57 of 65 Official leaderboard
Excel Modeling Benchmark 28.4% #67 of 76 Official leaderboard
Legal Research Bench 10.6% #83 of 93 Official leaderboard
Harvey LAB (Legal Agent Benchmark) 0% #72 of 80 Official leaderboard
Tax Agent Bench 6.87% #77 of 84 Official leaderboard
OccuBench 53.9% #13 of 14 Official leaderboard
Vals Finance Agent v2 27.9% #75 of 80 Official leaderboard
Agents' Last Exam 5.92% #30 of 31 Official leaderboard
APEX-1 45.8% #71 of 71 Official leaderboard
FORTE 49.5% #21 of 21 Official leaderboard

Vision, audio and robotics

BenchmarkScoreRankSource
MineBench 1,194 #57 of 75 Official leaderboard
AgentWorldBench 46.1 #13 of 13 Official leaderboard

Safety and security

BenchmarkScoreRankSource
SusVibes 18.8% #3 of 10 Official leaderboard
nocot-bench (NCRI) 64.0 #123 of 185 Official leaderboard
ExploitBench 13% #9 of 9 Official leaderboard
SMDD-Bench 19.3% #7 of 7 Official leaderboard

Other

BenchmarkScoreRankSource
Artificial Analysis Intelligence Index v4.0 50.0 #3 of 5 Lab model card

Its lab's numbers put it at 150.3, number 89 of 404

The Self-Reported Index fits one score to the 16 capability results MiniMax reported for this model, on the scale of the Epoch Capabilities Index. Labs choose which benchmarks to show and how to run them, so read it as the lab's claim, not an independent measurement. The 90% interval runs from 148.6 to 152.1. How we compute it.

Its lab's numbers next to 3 leaderboards

Where the benchmark's own leaderboard, or Epoch AI's run, also has this model. Gaps mostly come from different harnesses, effort levels and task subsets. Every pair.

Benchmark Lab says Board says Gap
Terminal-Bench 2.0 57% Terminal Bench 2 (text) 45.1% Leaderboard, IndusAGI Coding Agent +12 pts
MM-ClawBench 62.7% MM-ClawBench (MM Claw) 62.7% Leaderboard Same
Toolathlon 46.3% Toolathlon (Toolathon in text) 46.3% Leaderboard Same

Its launch post

The benchmarks the lab chose to headline, with the scores it gave.

Its system card

Every result in the longer documents the lab published with it. 14 of them aren't in the launch post.

AI R&D risk