Benchmark Almanac

GLM-5

GLM-5 ranks first on EvalPlus.

Z.ai Released February 11th, 2026 Family GLM-5 The lab's model card Compare with others
155
Benchmarks with a score
1
Ranked first, out of five or more models
9
In the top three
Z.ai Feb 2026

GLM-5

Open weights Flagship

146.5 #88 of 256
Epoch Capabilities Index
Self-Reported Index 147.9 #108 of 404
  • SWE-bench Verified 72.1% #22 /32
  • IFBench 72% #34 /80
  • Terminal-Bench 2.0 52.4% #16 /43

Where it ranks

Its best score on each benchmark, and where that ranks among every model with a score there. We rank each model once, at its best setting.

Knowledge and language

BenchmarkScoreRankSource
Judgemark v2.1 85.6 #4 of 42 Official leaderboard
MMLU-Pro 86% #27 of 212 Official leaderboard
LongBench v2 64.5% #5 of 35 Lab model card
LMArena (Elo) 1,457 #51 of 335 Official leaderboard
MMLU 88.3% #26 of 131 Lab model card
BIG-Bench Hard 87.4% #15 of 73 Lab model card
HellaSwag 88.1% #13 of 53 Lab model card
Humanity's Last Exam 50.4% #39 of 154 Lab model card
MultiChallenge 64.8% #11 of 42 Lab model card
PIQA 84.6% #10 of 37 Lab model card
EQ-Bench 3 1,495 #24 of 78 Official leaderboard
Longform Creative Writing (EQ-Bench) 70.9 #39 of 119 Official leaderboard
SimpleQA 36.9% #20 of 60 Lab model card
KINA 35.9% #14 of 37 Official leaderboard
Creative Writing v3 70.6 #50 of 120 Official leaderboard
IFBench 72% #34 of 80 Lab model card
TriviaQA 80.9% #17 of 40 Lab model card
CL-bench 18.7% #11 of 24 Official leaderboard
Chinese SimpleQA 75.2% #6 of 13 Lab model card
SkateBench v2 66.7% #10 of 21 Official leaderboard
C-Eval 88.8% #23 of 46 Lab model card
C3 80.3% #3 of 6 Lab model card
Extended NYT Connections 74.8% #52 of 103 Official leaderboard
AraGen 46% #23 of 42 Official leaderboard
Vectara Hallucination Leaderboard (2025 dataset) 10.1% #60 of 104 Official leaderboard
BullshitBench V2 28% #81 of 129 Official leaderboard
DesignArena ASCII Art 1,142 #50 of 77 Official leaderboard
BullshitBench 20% #71 of 107 Official leaderboard
CLUEWSC 84.2% #6 of 8 Lab model card
HLE Extended 2.00% #31 of 31 Official leaderboard
LOCA-Bench 4.00% #9 of 9 Official leaderboard
IF-Badcase 83.2% #1 of 1 Lab model card
MENT-SNS 1013.0 #1 of 1 Lab model card
Slide generation human evaluation (Z.ai) 67.5% #1 of 1 Lab model card
Translation Human Scoring (Z.ai) 3.12 #1 of 1 Lab model card
ZMultiDialBench 8.57 #1 of 1 Lab model card
ZMultiTransBench 1050.0 #1 of 1 Lab model card

Math and science

BenchmarkScoreRankSource
AIME 2025 96.7% #4 of 53 Official leaderboard
BRUMO 2025 99.2% #4 of 42 Official leaderboard
HMMT 2025 97.9% #6 of 54 Lab model card
General365 59.9% #3 of 23 Official leaderboard
HMMT Nov 2025 94.2% #3 of 22 Official leaderboard
CMIMC 2025 93.1% #5 of 33 Official leaderboard
SMT 2025 91% #8 of 40 Official leaderboard
AIME 2026 96.7% #9 of 31 Official leaderboard
GPQA Diamond 87.8% #67 of 229 Epoch AI run
MathArena (Apex, IMO, USAMO) 10.9% #21 of 47 Official leaderboard
OTIS Mock AIME 2024-2025 80% #97 of 212 Epoch AI run
MathArena Apex Shortlist 68.6% #18 of 38 Official leaderboard
FrontierMath 16.4% #27 of 55 Official leaderboard
ForecastBench 0.13 #42 of 82 Official leaderboard
IMO-AnswerBench 82.5% #19 of 37 Lab model card
SimpleBench 53.2% #55 of 106 Official leaderboard
ChemBench 59.3% #13 of 24 Official leaderboard
KellyBench -51.60% #3 of 5 Official leaderboard
MATH 56.4% #62 of 99 Lab model card
FrontierMath Tier 4 2.10% #38 of 55 Epoch AI run
ARC-AGI-2 4.86% #70 of 98 Official leaderboard
ARC-AGI 44.7% #70 of 95 Official leaderboard
HMMT 2026 86.4% #23 of 31 Official leaderboard
Echo General AI Prediction Leaderboard 984 #13 of 17 Official leaderboard
GSM8K 68.8% #73 of 92 Lab model card
USAMO 2026 35.1% #9 of 9 Official leaderboard

Coding

BenchmarkScoreRankSource
EvalPlus 87% #1 of 6 Lab model card
IOI (Vals) 22% #20 of 55 Official leaderboard
DesignArena Game Dev 1,224 #54 of 143 Official leaderboard
Spider 2.0 50.3% #9 of 23 Official leaderboard
DesignArena Code 1,237 #56 of 143 Official leaderboard
DesignArena 3D Design 1,212 #54 of 136 Official leaderboard
DesignArena Website 1,241 #62 of 151 Official leaderboard
DesignArena Data Visualization 1,226 #52 of 118 Official leaderboard
WeirdML 48.2% #51 of 112 Official leaderboard
DesignArena UI Component 1,222 #66 of 139 Official leaderboard
SWE-bench Multilingual 73.3% #35 of 73 Lab model card
AutoLab 0.43 #5 of 10 Official leaderboard
OJBench 54.9% #4 of 8 Official leaderboard
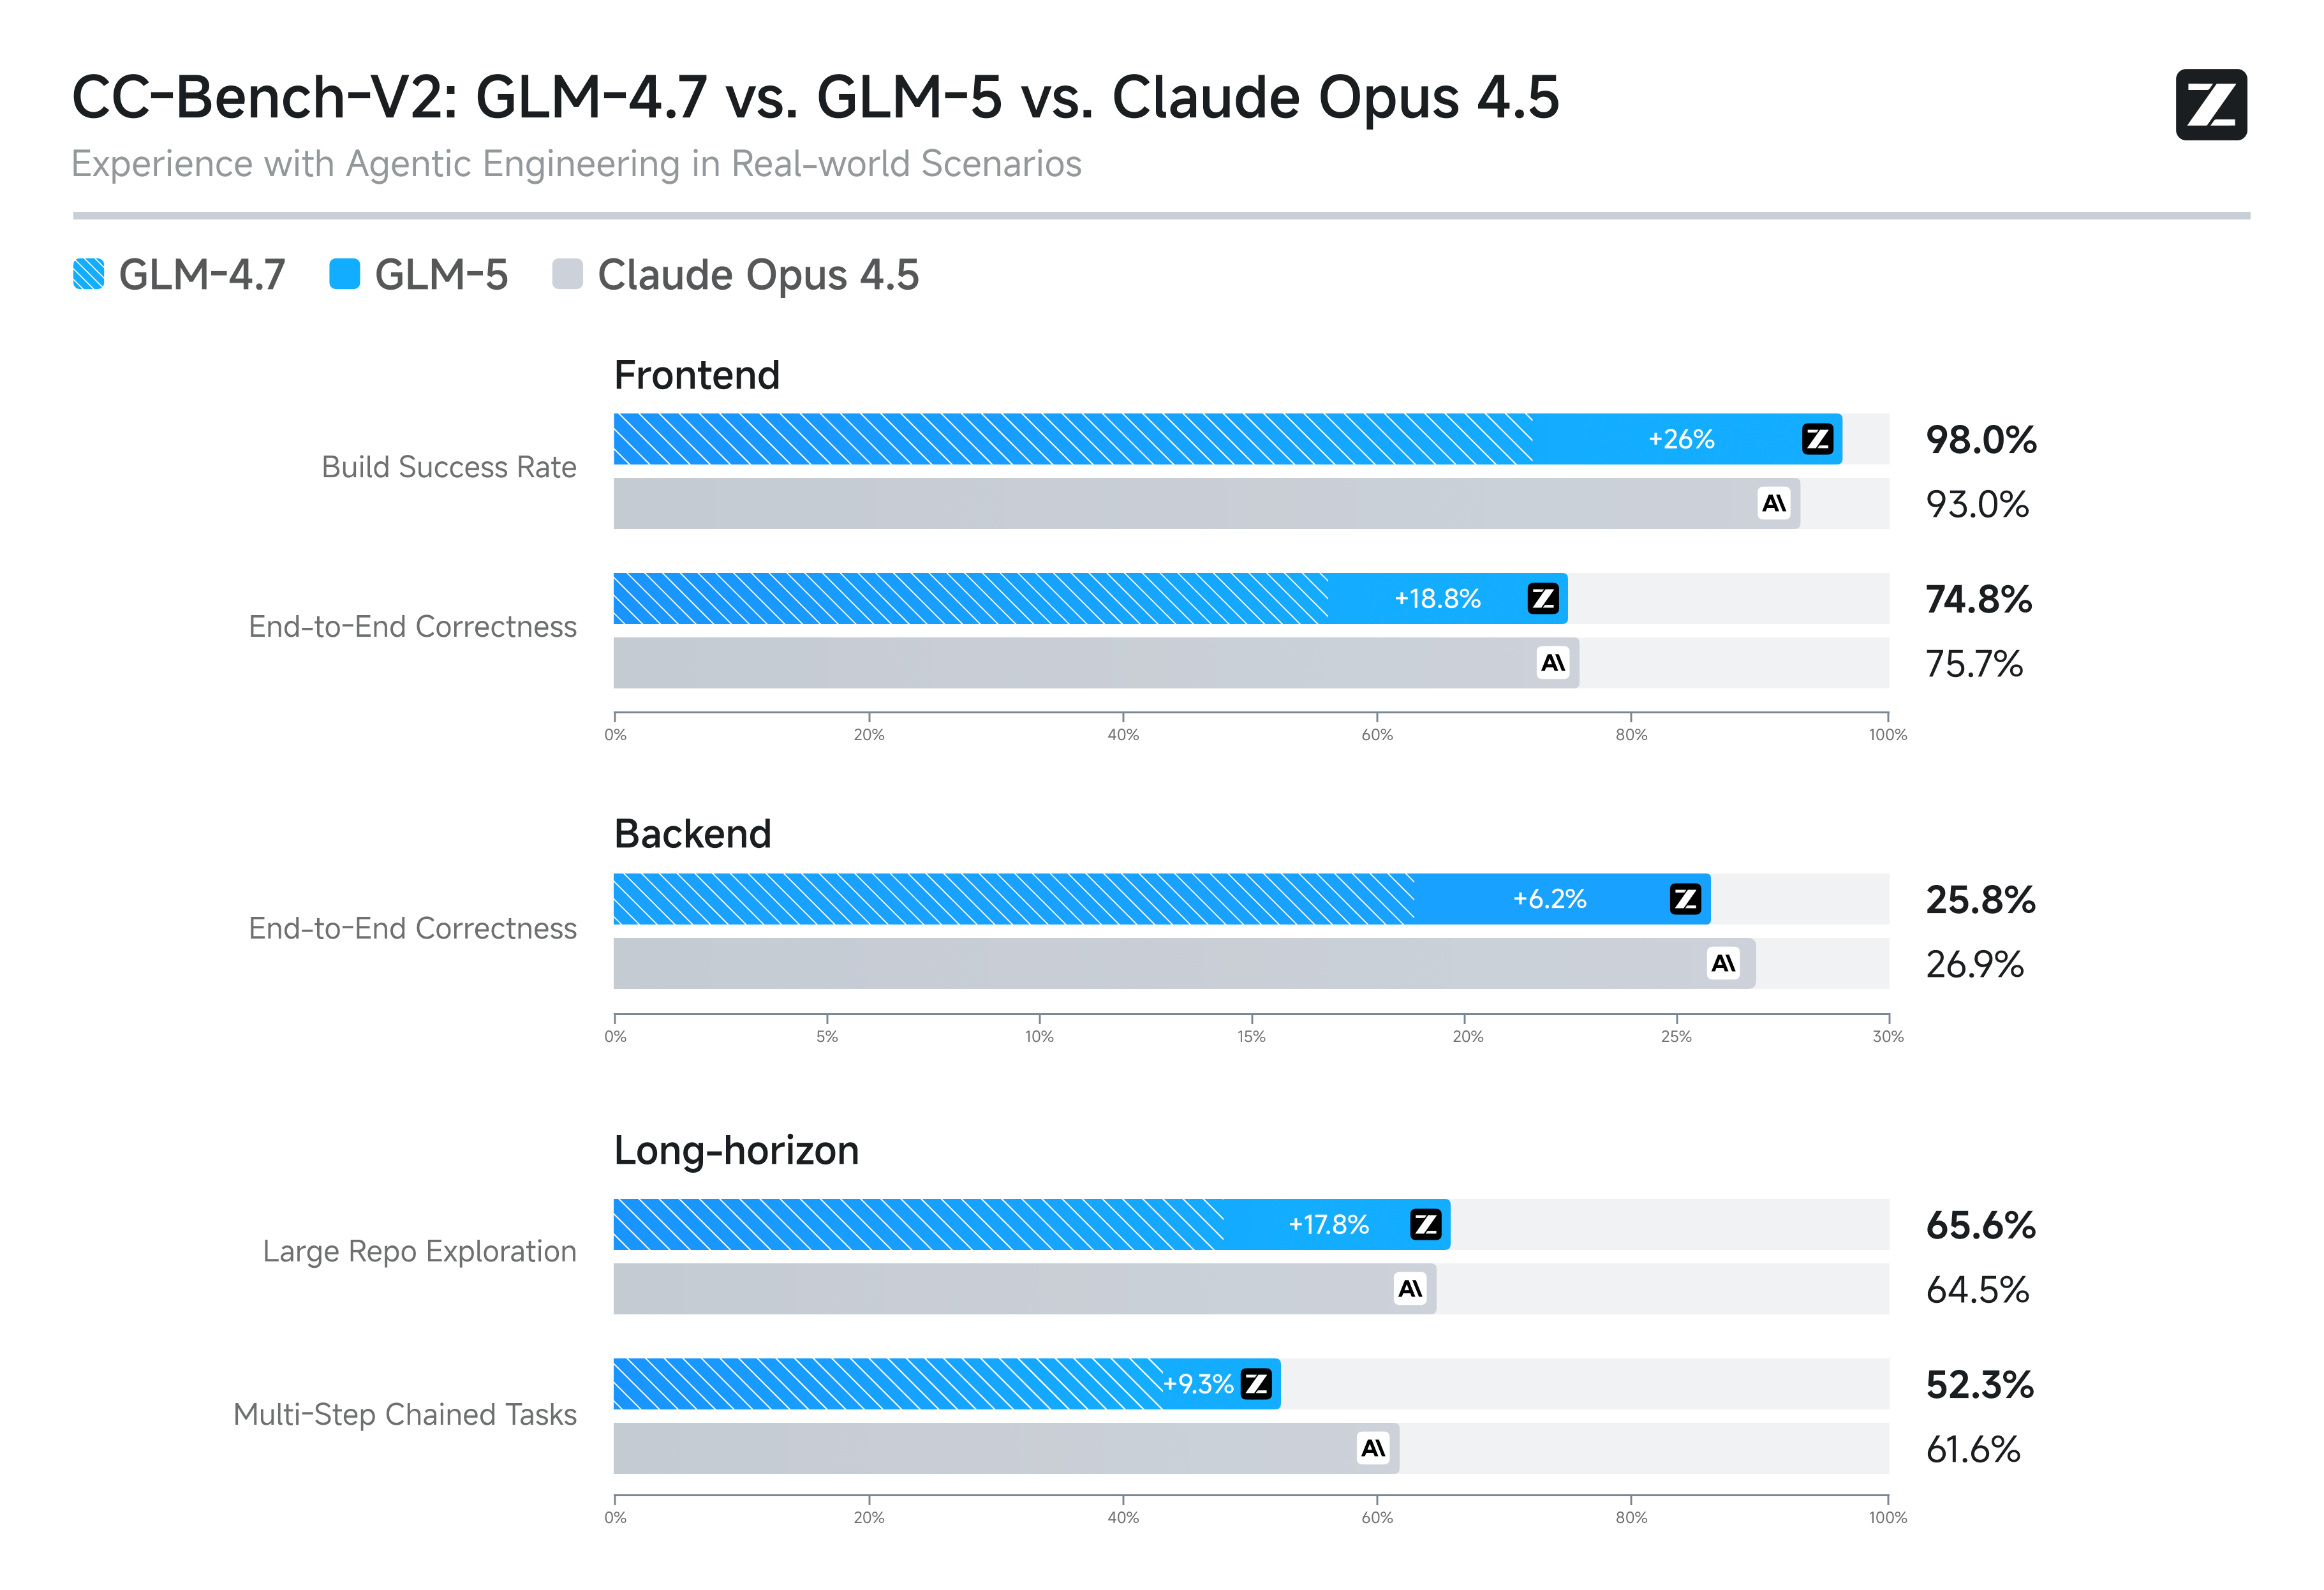
CC-Bench-V2 Backend 25.8% #1 of 2 Lab model card
CC-Bench-V2 Frontend 74.8% #1 of 2 Lab model card
OpenHands Index 49.4% #17 of 33 Official leaderboard
DesignArena SVG 1,159 #55 of 103 Official leaderboard
WebDev Arena 1,436 #59 of 105 arena.ai, via Epoch AI
Code Arena 1,435 #76 of 128 Official leaderboard
DesignArena Agentic Overall 1,108 #49 of 74 Official leaderboard
ALE-Bench 1,194 #84 of 126 Official leaderboard
DesignArena Full Stack 1,101 #33 of 49 Official leaderboard
SWE-bench Verified 72.1% #22 of 32 Epoch AI run
Vibe Code Bench 23.4% #83 of 120 Official leaderboard
PostTrainBench 13.9% #16 of 23 Official leaderboard
DesignArena Android (Kotlin) 1,135 #33 of 46 Official leaderboard
DesignArena React Native 1,130 #41 of 56 Official leaderboard
DAXBench v2 66% #37 of 47 Official leaderboard
SWE Atlas 20.5% #18 of 22 Official leaderboard
SWE Atlas Refactoring 24.2% #14 of 17 Official leaderboard
SWE Atlas Test Writing 28.7% #19 of 22 Official leaderboard
CC-Bench-V2 Large Repo Exploration 65.6% #2 of 2 Lab model card
CC-Bench-V2 Multi-Step Chained Tasks 52.3% #1 of 1 Lab model card
SWE-rebench 42.1% #1 of 1 Lab model card

Agents and tools

BenchmarkScoreRankSource
SnakeBench 31 #36 of 188 Official leaderboard
PinchBench 76.2% #10 of 48 Official leaderboard
tau2-bench 89.7% #17 of 79 Lab model card
Claw-Eval-Live 61.9% #3 of 12 Official leaderboard
BrowseComp-ZH 72.7% #5 of 19 Lab model card
Terminal-Bench 2.0 52.4% #16 of 43 Official leaderboard
Toolathlon 39.2% #20 of 50 Official leaderboard
LisanBench 986.8 #56 of 133 Official leaderboard
BrowseComp 75.9% #40 of 81 Lab model card
WildClawBench 46.4% #19 of 31 Official leaderboard
QwenClawBench 54.9% #8 of 12 Official leaderboard
ClawProBench 57% #33 of 49 Official leaderboard
MCP Atlas 67.8% #32 of 46 Lab model card
EnvSimBench 41% #5 of 7 Official leaderboard
MM-BrowseComp 3.25% #8 of 11 Official leaderboard
LLM Chess -299 #101 of 123 Official leaderboard
tau3-bench 81% #6 of 7 Official leaderboard
DeepPlanning 14.6% #13 of 15 Official leaderboard
Pencil Puzzle Bench 0% #46 of 53 Official leaderboard
RuneBench 1.90 #71 of 76 Official leaderboard
τ³-bench Banking 9.79% #24 of 25 Official leaderboard
ToolCall-Badcase 95.8% #1 of 1 Lab model card

Professional work

BenchmarkScoreRankSource
LegalBench 84.1% #42 of 138 Official leaderboard
Vals Index v1 55.1% #13 of 34 Official leaderboard
StrataBench Land v1 Extract 88% #2 of 5 Official leaderboard
CorpFin v2 62.9% #48 of 119 Official leaderboard
YC-Bench $1,208,190 #25 of 59 Official leaderboard
Vals Finance Agent 53.2% #21 of 49 Official leaderboard
Vending-Bench Arena $5,582 #16 of 32 Official leaderboard
SpreadsheetBench 2 17.1% #4 of 8 Official leaderboard
Vending-Bench 2 $4,432 #39 of 67 Official leaderboard
AlphaEval 49.9% #3 of 5 Official leaderboard
TaxEval v2 70% #88 of 129 Official leaderboard
OccuBench 62.6% #10 of 14 Official leaderboard
ProfBench 43.3% #52 of 72 Official leaderboard
DesignArena HTML Slides 1,043 #22 of 28 Official leaderboard
FORTE 60.7% #17 of 21 Official leaderboard
CaseLaw v2 52.5% #45 of 53 Official leaderboard
GDPval-AA 1,409 #14 of 16 Lab model card
BankerToolBench v1.1 4.70% #9 of 10 Official leaderboard
EnterpriseBench: CoreCraft 17.4% #46 of 51 Official leaderboard
FoodTruck Bench $-210 #57 of 59 Official leaderboard

Vision, audio and robotics

BenchmarkScoreRankSource
MineBench 1,214 #55 of 75 Official leaderboard

Safety and security

BenchmarkScoreRankSource
BioTIER Permit 99.7% #21 of 69 Official leaderboard
nocot-bench (NCRI) 76.2 #72 of 185 Official leaderboard
LiveSecBench 56.7 #16 of 34 Official leaderboard
Human Pathogen Capabilities Test 53.4% #41 of 86 Official leaderboard
SusVibes 14% #5 of 10 Official leaderboard
KORA 40.6% #22 of 42 Official leaderboard
DistressBench 71.2% #23 of 42 Official leaderboard
Molecular Biology Capabilities Test 48% #50 of 90 Official leaderboard
BioTIER Refuse 33.9% #40 of 69 Official leaderboard
CyberGym 43.2% #20 of 34 Official leaderboard
BinaryAudit 19.3% #12 of 20 Official leaderboard
SEC-bench Pro 3.80% #4 of 6 Official leaderboard
SEC-bench Pro 260617 3.80% #4 of 6 Official leaderboard
World-Class Bio 38.4% #50 of 74 Official leaderboard

Other

BenchmarkScoreRankSource
Artificial Analysis Intelligence Index v4.0 50.0 #2 of 5 Lab model card

Its lab's numbers put it at 147.9, 1.4 points above its ECI

The Self-Reported Index fits one score to the 28 capability results Z.ai reported for this model, on the scale of the Epoch Capabilities Index. Labs choose which benchmarks to show and how to run them, so read it as the lab's claim, not an independent measurement. The 90% interval runs from 144.5 to 151.3. How we compute it.

Its lab's numbers next to 16 leaderboards

Where the benchmark's own leaderboard, or Epoch AI's run, also has this model. Gaps mostly come from different harnesses, effort levels and task subsets. Every pair.

Benchmark Lab says Board says Gap What differs
SWE-bench Verified 77.8% SWE-bench Verified 72.8% Leaderboard, high, mini-SWE-agent +5.0 pts
AIME 2026 92.7% AIME 2026 I 96.7% Leaderboard −4.0 pts
Terminal-Bench 2.0 56.2% Terminal-Bench 2.0 (Terminus 2) 52.4% Leaderboard, Terminus 2 +3.8 pts
SWE-bench Multilingual 73.3% SWE-bench Multilingual 69.7% Leaderboard, mini-SWE-agent +3.6 pts
HMMT Nov 2025 96.9% HMMT Nov. 2025 94.2% Leaderboard +2.7 pts
GPQA Diamond 86% GPQA-Diamond 87.8% Epoch AI run −1.8 pts
Code Arena 1,449 LMArena Code Arena (Agentic WebDev) score, rank 6 (Figure 3 screenshot) 1,435 Leaderboard +14 The lab reproduces an early Code Arena snapshot, while the board uses a later rating from additional votes.
HMMT 2025 97.9% HMMT Feb. 2025 (Table 7) 97.5% Leaderboard +0.4 pts
LMArena (Elo) 1,452 LMArena Text Arena score, rank 11 (Figure 3 screenshot); LMsys Chatbot Arena 1452 (Figure 11) 1,457 Leaderboard −5 Z.ai quotes an earlier Arena rating, while the board reports a later rating from updated votes and scoring.
CC-Bench-V2 Backend 25.8% CC-Bench-V2 Backend Engineering, Pass@1 (Table 8) 25.8% Leaderboard Same
CC-Bench-V2 Multi-Step Chained Tasks 52.3% CC-Bench-V2 Long-horizon Chained Tasks, Pass@1 (Table 8) 52.3% Leaderboard Same
CC-Bench-V2 Frontend 74.8% CC-Bench-V2 Frontend, End-to-End Correctness (Figure 4). Build Success Rate 98.0; per-stack ISR/CSR in Table 8 74.8% Leaderboard Same
CC-Bench-V2 Large Repo Exploration 65.6% CC-Bench-V2 Long-horizon Repo Exploration, Pass@1 (Table 8) 65.6% Leaderboard Same
CyberGym 43.2% CyberGym 43.2% Leaderboard, Claude Code Same
Toolathlon 39.2% Tool-Decathlon (Table 7) 39.2% Leaderboard Same
Vending-Bench 2 $4,432 Vending Bench 2 $4,432 Leaderboard Same

Z.ai's models over time

Z.ai's models in color, against every other model on the Epoch Capabilities Index, by release date.

50 100 150 2023 2024 2025 2026 2027 GLM-5.3-Flash GLM-5 50 100 150 2023 2024 2025 2026 2027 GLM-5.3-Flash GLM-4.7

Source: Epoch Capabilities Index, Epoch AI (CC BY 4.0)

Its launch post

The benchmarks the lab chose to headline, with the scores it gave.

Its system card

Every result in the longer documents the lab published with it. 34 of them aren't in the launch post.

Hallucination

Cyber risk